被忽视的另一半
监控不是问题,没人回应的监控才是
很多团队的监控停在"有仪表盘"这一步——图表画得很漂亮,却从来没人盯着;告警配置成了摆设:要么太敏感,每天几十条消息把人训练成"已读不回";要么太迟钝,故障已经发生大半才姗姗来迟。
阈值配置一次就再也没人回顾过,业务规模翻了三倍,告警线还停在最初的数字
半夜的告警消息里只有一句「CPU 过高」,没有任何上下文,只能现查现分析
告警太多、太杂,团队早已把通知渠道设成了免打扰
01 · 全维度采集
看全,才能看准
WAP 同时采集主机层与 MongoDB 实例层的指标——从最基础的 CPU、内存、磁盘 IO,到连接数、复制延迟、锁等待、慢查询占比,每一项都被逐秒记录,而不是抽样估算。
主机层指标
CPU · 内存 · 磁盘 IO · 网络吞吐
实例层指标
连接数 · 队列长度 · 操作计数器 · 缓存命中率
复制健康度
选举频率 · oplog 延迟 · 心跳状态
查询层指标
慢查询占比 · 锁等待时间 · 扫描效率
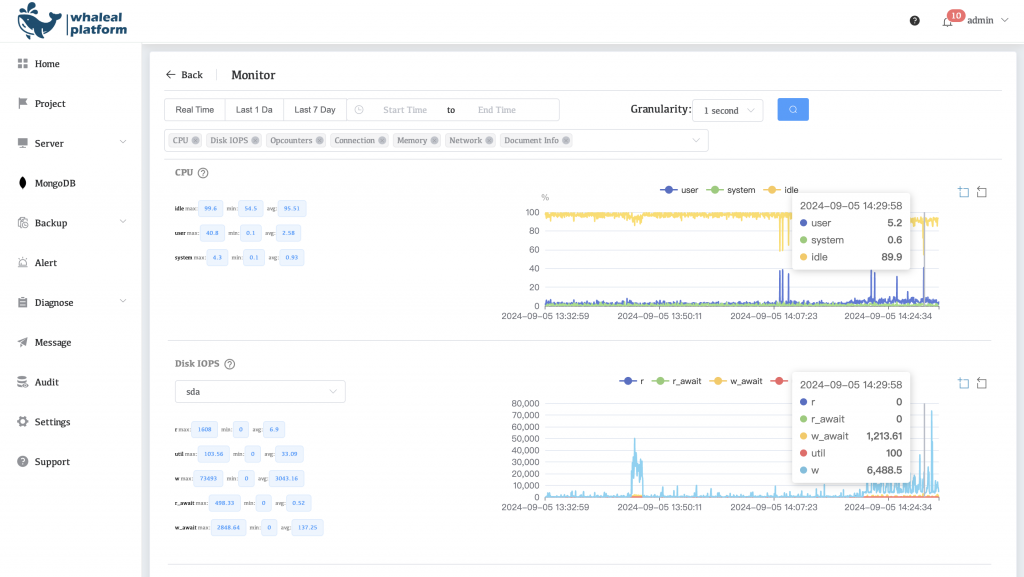
Detail Metrics
详细监控指标
逐项指标可视化,异常一眼可见。
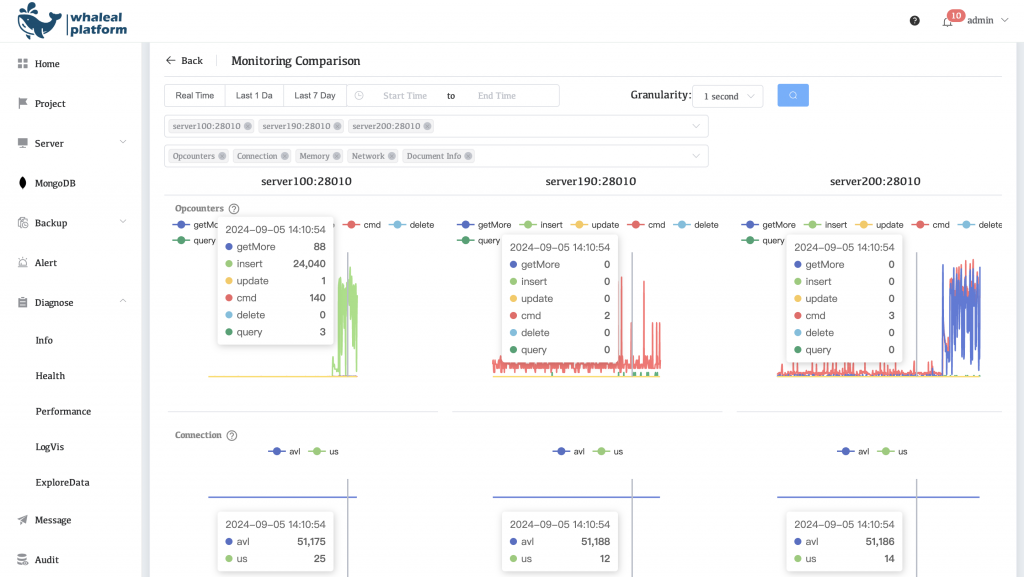
Compare
多维对比分析
跨节点、跨集群横向对比。
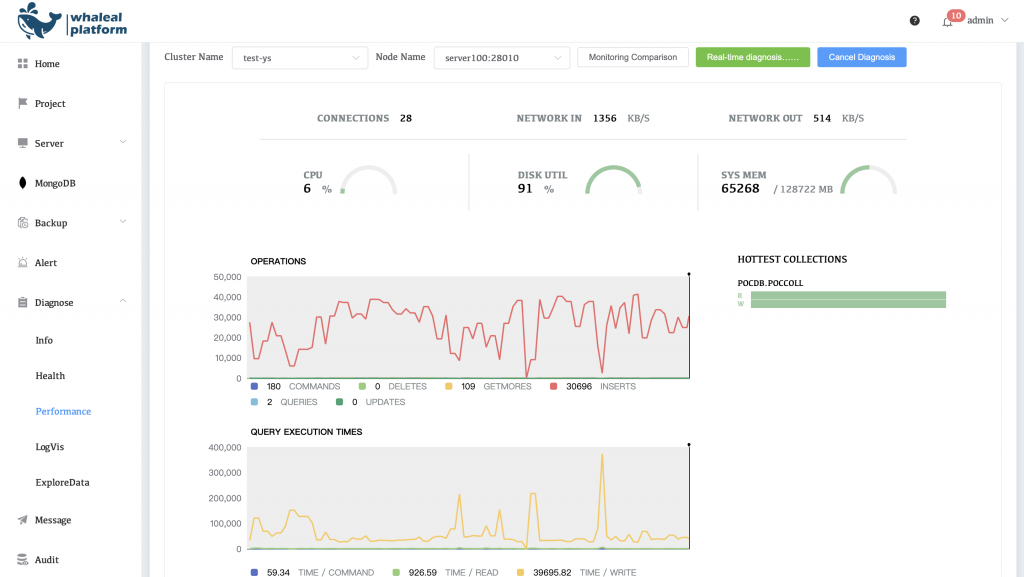
Real-time
实时性能诊断
健康状况实时刷新,风险提前预警。
02 · 分级告警
告警,不是「发通知」
真正有用的告警系统,核心不是"触发条件",而是"分级响应"。同一个 CPU 过高,发生在业务低峰期和大促高峰期,该走的处理路径完全不同。
STEP 1
指标越线
实时比对采集值与阈值
→
STEP 2
严重程度分级
信息 / 警告 / 严重
→
STEP 3
去重与收敛
同一问题不再重复轰炸
→
STEP 4
精准送达
按严重程度路由到合适渠道
03 · 从告警到根因
告警响起的同时,原因已经摆在你面前
大多数告警系统只负责喊"有问题",剩下的排查工作留给人。WAP 的告警会自动附带上下文——把"发现问题"和"定位原因"这两步合并成一步。
[告警] 分片 shard02 复制延迟达到 128ms,超过阈值 100ms
[关联指标] 该节点磁盘 IO 使用率同一时段升至 92%
[根因推测] 大概率为磁盘 IO 瓶颈导致 oplog 应用滞后
[建议]
检查该节点磁盘队列深度,或临时降低该节点的读流量权重以缓解压力。